
Dix passages, dix analyses : quand la mesure remplace le soupçon
Une œuvre peut-elle tomber malade d’un chiffre ?
Il suffit désormais qu’un logiciel affiche un pourcentage pour qu’un livre, jusque-là offert à la lecture, entre soudain dans l’ère du soupçon. Le texte demeure le même, les phrases n’ont pas bougé, les personnages continuent leur chemin ; pourtant, quelque chose s’est brisé autour de lui. Un nombre s’est interposé entre l’auteur et son lecteur.
70 %. 80 %. 90 %.
Et voici qu’un indice statistique, dont on ignore souvent la formule, le poids des variables, leur articulation et parfois même les limites, acquiert peu à peu la solennité d’un verdict.
C’est au chevet de cette œuvre que Mondagora IA Detect a choisi de se placer.
Non pour délivrer un certificat d’innocence. Non plus pour opposer à une machine accusatrice une autre machine qui absoudrait. Ce serait reproduire, en sens inverse, exactement la faute que nous contestons : demander à un calcul de trancher ce que le calcul, à lui seul, ne peut établir.
Nous avons choisi une voie plus austère : ouvrir le roman de Télyson Orélien, l’observer, mesurer ses régularités et montrer ce que l’instrument voit.
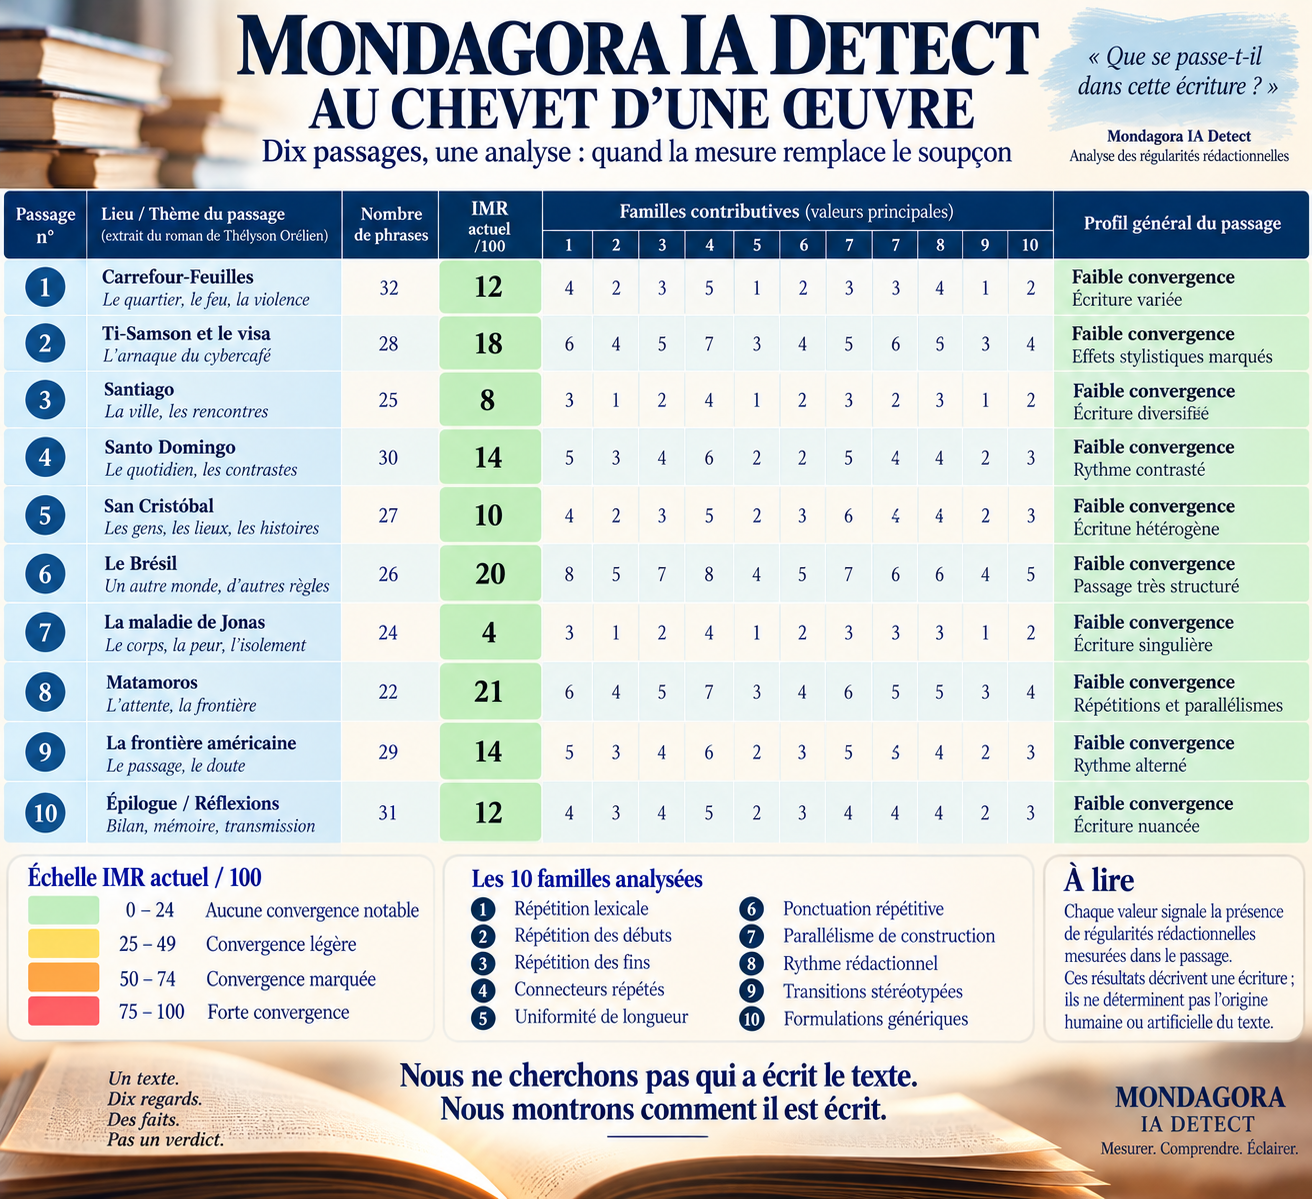
Dix passages ont ainsi été soumis à l’analyse.
Dix prélèvements dans une même œuvre.
Et, pour chacun, la même règle : l’algorithme ne connaît ni la réputation de l’auteur, ni la controverse qui l’entoure, ni la réponse que nous souhaiterions obtenir.
Car Mondagora IA Detect ne pose pas la question qui obsède notre époque :
« Est-ce une intelligence artificielle qui a écrit cela ? »
Il en pose une autre, beaucoup plus modeste et peut-être beaucoup plus féconde :
« Que se passe-t-il dans cette écriture ? »
Dans notre modèle, le résultat procède de phénomènes rédactionnels identifiables : répétition lexicale, répétition des débuts, répétition des fins, connecteurs répétés, uniformité de longueur, ponctuation répétitive, parallélisme de construction, rythme rédactionnel, transitions stéréotypées et formulations génériques.
Lorsqu’un marqueur s’allume, on peut donc revenir au texte et poser une question simple : qu’est-ce qui a produit ce signal ?
C’est une propriété essentielle : l’interprétabilité.
Le problème apparaît lorsqu’un système délivre une probabilité synthétique sans rendre suffisamment intelligibles les variables observées, leur pondération, leurs interactions ou les conditions dans lesquelles son modèle a été calibré. Le chiffre demeure alors visible tandis que son architecture disparaît.
C’est précisément là que les faux positifs deviennent problématiques. Un texte peut recevoir un score élevé sans que son lecteur puisse déterminer clairement pourquoi il l’a reçu.
Notre expérience des dix fragments illustre l’intérêt d’une autre démarche. Certaines phrases présentent localement des régularités plus sensibles que d’autres : répétitions, parallélismes, reprises syntaxiques, effets de cadence. Pourtant, à l’échelle des passages étudiés, l’IMR actuel demeure dans la zone verte, celle de l’absence de convergence notable.
Cette distinction est capitale.
« Tu vas te lever. Tu vas boire. Tu vas marcher. »
La construction est manifestement répétitive. Mais cette répétition peut être rhétorique, narrative, affective, volontaire. Elle produit une cadence ; elle peut traduire l’insistance d’une voix, la montée d’une émotion ou la volonté de marteler une idée. Sa présence constitue donc un phénomène observable, non une preuve d’origine.
Confondre la détection d’une régularité avec l’identification de celui — ou de ce qui — a écrit la phrase reviendrait à franchir, sans démonstration, la distance qui sépare un indice stylistique d’une attribution.
C’est précisément cette distance que Mondagora IA Detect entend préserver.
Notre principe méthodologique pourrait tenir en trois verbes :
Mesurer d’abord. Montrer ensuite. Ne jamais attribuer l’auteur.
À cette prudence s’ajoute une autre exigence : la traçabilité du score.
L’utilisateur doit pouvoir comprendre le cheminement qui conduit du texte au résultat :
texte → marqueurs observables → intensité des marqueurs → régularités locales → agrégation documentaire → IMR final.
Le nombre cesse alors d’être un oracle.
Il devient une radiographie.
C’est également sous cet angle que peut être interrogée la logique de certains détecteurs fondés sur une probabilité globale : une probabilité dont la décomposition demeure insuffisamment explicite peut rendre difficile l’identification des mécanismes ayant produit le résultat et, par conséquent, l’examen critique d’un éventuel faux positif.
La nuance est importante. Il ne s’agit pas d’affirmer que toute méthode probabiliste serait erronée, pas davantage de prétendre que notre méthode détiendrait une vérité inaccessible aux autres. Il s’agit de défendre une exigence plus élémentaire : plus un chiffre risque d’entraîner des conséquences pour un auteur, un étudiant, un journaliste ou un chercheur, plus celui qui le reçoit devrait pouvoir comprendre ce qu’il mesure réellement.
Nos dix analyses font ainsi apparaître une propriété particulièrement intéressante de l’IMR : une singularité locale n’est pas automatiquement transformée en convergence générale.
Une phrase peut répéter. Une autre peut épouser un parallélisme presque parfait. Une troisième peut adopter une cadence régulière. Ces phénomènes existent ; l’outil les montre. Mais leur existence isolée ne suffit pas à raconter l’ensemble du texte.
C’est peut-être là que réside la différence essentielle.
Mondagora IA Detect ne cherche pas à fabriquer un meilleur tribunal.
Il cherche à supprimer le tribunal de la machine.
Un texte. Des marqueurs. Des mesures. Une explication.
Puis le lecteur reprend ses droits.
GIGI
Partagez ce contenu / Condividi questo contenuto: